外贸导出客户线索后如何清洗与分级:2026 中国 SDR 团队的 Lead Cleanup SOP
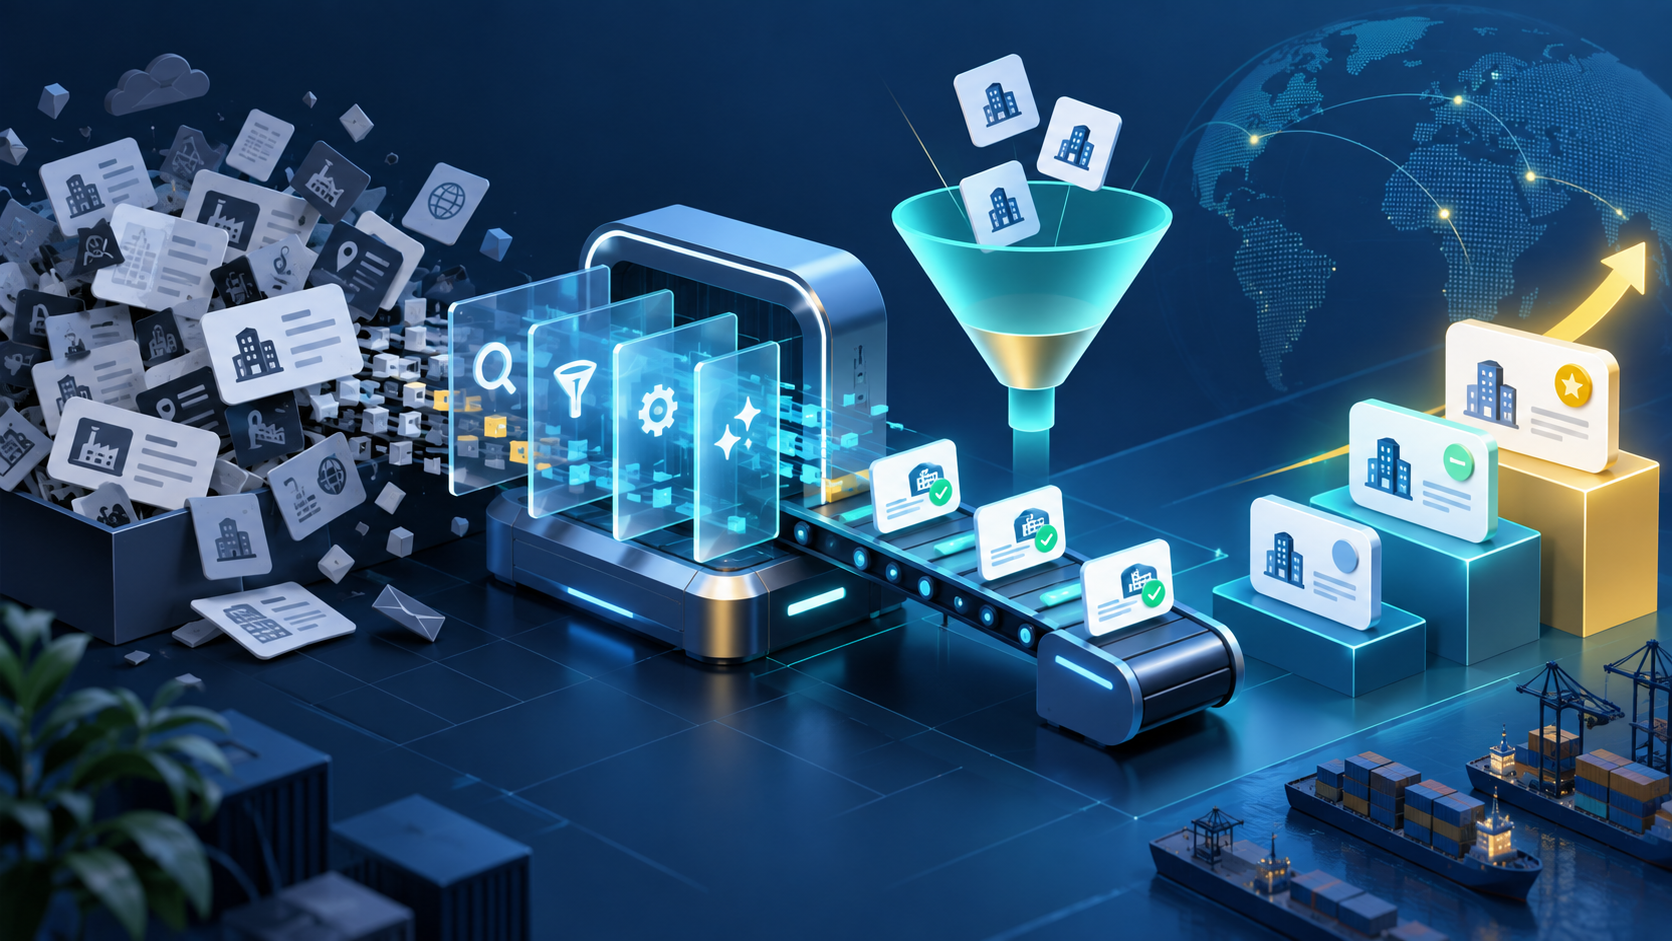
把 Sales Navigator / Apollo / ZoomInfo / Lusha 导出的客户线索,用 6 步 SOP 清洗并按 4 级 Tier 分级,是 2026 中国 SDR 团队从同一份干净数据出发的最低门槛。导出工具的字段差异决定了清洗的起点,而不是终点;下游的邮件、外呼、内容投放都依赖这一份干净数据。如果起点的数据不干净,下游的所有动作都会带着噪声运行,营销预算会被浪费在不存在或不匹配的联系人上。
Bouncer 2026 邮件验证资料给出的口径是:B2B 邮件列表的平均无效率约 22%,其中角色邮箱(info@ / contact@)和失效个人邮箱占主体;如果按逐条校验 + SMTP 验证 + 拼写纠错的三段流程做,命中率可提升约 38 个百分点。这 38 个百分点决定了 SDR 每天的有效触达数,也决定了后续 30 天的邮件送达率和发件人域名信誉度。
Apollo 2026 lead data quality 资料给出的另一个口径是:B2B 联系方式的年衰减率约 22.5%,岗位变更导致的失效占整体衰减的 35%。这意味着即使导出当天的数据是干净的,90 天后再触达也会有相当比例的邮箱失效,因此建议每 90 天对核心账户做一次再校验,并把校验时间戳写进 CRM。
第一步:邮箱校验(Email Verification)
邮箱校验不是一次性动作,而是清洗流程的入口。校验流程至少包含三层:格式校验(域名拼写、MX 记录、是否存在一次性邮箱服务商)、SMTP 校验(收件服务器是否真正接受投递)、角色邮箱识别(info@ / sales@ / contact@ 等通用邮箱)。三层校验之后的命中率比单层校验高 30 个百分点以上。
校验结果的字段至少应包含:邮箱、校验状态(valid / invalid / accept-all / role-based / disposable)、校验时间戳、来源工具。对 invalid 邮箱直接标记为丢弃,对 accept-all 邮箱按需保留,对 role-based 邮箱作为辅助联系人使用。
第二步:公司名规范化(Company Normalization)
导出工具返回的公司名字段经常存在四种漂移:英文拼写漂移(如 ACME vs Acme Inc)、行业词混入(如 Shenzhen ACME Manufacturing Co., Ltd)、子公司与母公司混用(Acme China vs ACME Group)、同名公司歧义(同名的本地贸易商和跨国集团)。这四种漂移加起来占常见清洗任务的 40% 以上。
规范化的方法是建立一个内部 ICP 公司词典,把导出字段映射到词典中的标准公司名。映射规则至少包括:母公司吸收规则(保留母公司)、行业词剥离规则(去除 Co., Ltd 等后缀再匹配)、同名公司歧义消解规则(按域名 + 行业 + 区域消歧)。规范化的输出是一列带主键的标准化公司名,可以直接喂给下游的 CRM 字段。
第三步:角色定位(Role Targeting)
角色定位用职位族(function)而不是单一名片。常见的角色族包括决策影响人(CEO / GM / VP)、评估人(采购 / 工程 / 质量)、使用者(一线操作 / 项目经理)、守门人(行政 / 助理 / 前台)。每个角色族对应不同的触达内容、不同的报价口径、不同的跟进节奏。
Lusha 2026 Sales Navigator lead cleanup 资料给出的五个常见脏数据陷阱中,第三个就是职位族过度泛化。导出工具经常把 Senior / Manager / Lead 这种修饰词作为独立职位返回,导致下游触达脚本无法匹配。规范化的方法是把职位族映射到 8–12 个内部角色标签,每个标签对应一个触达模板和报价口径。
第四步:行业匹配(Industry Match)
行业匹配把导出工具返回的行业字段(SIC / NAICS / 公司自填)映射到内部行业标签。ZoomInfo 2026 B2B data accuracy 资料显示,导出后的公司在 SIC / NAICS / 行业子类上的错位占常见清洗任务的 40% 以上;建议把字段重写为内部 ICP 标签,而不是依赖原始数据维度。
匹配规则的输入是原始行业字段,输出是内部行业标签(如 precision parts / industrial consumables / OEM manufacturer / trading company / brand owner)。每个标签对应一个产品 SKU 组合和一个报价模板,可以避免下游触达把消费品行业的报价模板发给工业品采购负责人。
第五步:信号标注(Signal Annotation)
信号标注把外部可观察的变化叠加到联系人身上,作为前置过滤。Demandbase 2026 account intent 资料指出,技术栈替换、设备采购周期、供应链转移属于 long-cycle 信号,需要 2–3 个季度持续观察才能形成稳定的机会;短期单一信号不应直接判定为机会。
短周期信号(招聘扩张 / 融资公告 / 政策合规变化)可以立即触达,但应标注来源、日期、可信度;长周期信号(技术栈替换 / 设备采购周期 / 供应链转移)应进入观察池,每 30 天重新评分。评分规则建议公开,避免销售自行加权。
第六步:BANT 预审(BANT Pre-qualification)
BANT 预审在清洗流程末端做一次轻量级预审,预审字段包括 Budget(预算口径)、Authority(决策权)、Need(需求强度)、Timeline(采购时间窗)。预审的输出是一列 Tier 标记,不是字段填空。
4 级 Tier 的口径建议如下:Hot Tier 同时具备 Budget + Authority + Need + Timeline;Warm Tier 具备 Authority + Need,缺 Budget 或 Timeline;Nurture Tier 具备 Need,缺 Budget / Authority / Timeline;Discard Tier 缺 Need 或多个字段空缺。Tier 直接驱动下游触达节奏:Hot 24 小时内触达,Warm 72 小时内触达,Nurture 进入长培育池,Discard 不触达。
Cognism 2026 data quality framework 资料把数据质量分成 completeness / accuracy / timeliness / consistency 四维,并指出四维中任意一项低于阈值就会显著影响 SDR 的触达转化。Tier 分级本质上是四维质量评估的下游应用。
5 个常见脏数据陷阱与修复口径
陷阱一:邮箱拼写漂移。修复口径是三层校验 + 主键匹配。
陷阱二:子公司与母公司混用。修复口径是母公司吸收规则。
陷阱三:个人名片与公司域名错位(名片公司是 A 公司,邮箱域名是 B 公司)。修复口径是域名优先,名片次之;域名错位的名片标记为待核验。
陷阱四:职位族过度泛化。修复口径是角色族映射到 8–12 个内部标签。
陷阱五:行业标签与采购语言不一致。修复口径是 ICP 行业词典 + 二次匹配。
一份 7 天的执行节奏
Day 1:导出 + 邮箱三层校验。Day 2:公司名规范化 + 角色定位。Day 3:行业匹配 + 信号标注。Day 4:BANT 预审 + 4 级 Tier 标记。Day 5:Hot Tier 触达脚本与首批外呼。Day 6:Warm Tier 邮件序列 + Nurture Tier 长培育池。Day 7:复盘命中率 + Tier 分布 + 字段缺失原因。
7 天节奏的关键不是每天都做完所有步骤,而是让数据每天都在向更干净的方向移动。Tier 标记不是终点,是下游触达的起点。
数据治理的可审计性
清洗流程的每一步都应有可审计的日志:谁触发的、用什么规则、输入字段是什么、输出字段是什么、校验时间戳是多少。可审计的日志让 Tier 分布可以回溯,让字段缺失可以追责,让营销预算的下游投放有据可查。
一份干净数据的真正价值,不在 Tier 标记本身,而在 Tier 标记背后的可审计链条。跨境销邦可帮助你把清洗、分级、触达节奏放进同一套工作流,让数据治理的可审计链条成为下一次营销复盘的入口,而不是下一次营销预算的隐形成本。 ## 与传统“名单即机会”思路的对比
传统“名单即机会”思路依赖名单数量,不依赖名单质量。大量名单进入外呼池后被快速消耗,真正有效的线索不到 5%。6 步清洗流程的产出是 5%–15% 的 Hot / Warm Tier,而不是 100% 的“名单”。
名单数量重要,但名单可触达更重要。Tier 分级的输出是一份带优先级、带节奏、带责任人的机会池,而不是一份带邮箱的名单。机会池可以分批触达、按周复盘、按月迭代;名单只能一次性消耗。
数据治理的边界
数据治理不是万能解药。Tier 分级依赖 ICP 词典的完整度,ICP 词典依赖销售团队对客户画像的共识。共识越清晰,Tier 分级越精准;共识越模糊,Tier 分级越接近随机。
数据治理的可审计链条是它的真正价值:字段缺失可以追责、规则漂移可以回滚、Tier 分布可以复盘。没有可审计链条的 Tier 分级,本质上还是名单即机会的现代版本。
一份 30 天的复盘框架
Day 30:复盘命中率(每 100 条导出线索转化为 Hot Tier 的数量)、Tier 分布(Hot / Warm / Nurture / Discard 的比例)、字段缺失原因(哪些字段缺失最多、为什么)、ICP 词典更新(基于实际客户画像修订词典)、责任到人执行(每个责任人的转化率)。
复盘不是终点的复盘,而是下一次起点的起点。一份干净数据 + 一份可审计链条 + 一份 30 天复盘框架,是 2026 中国 SDR 团队从“靠名单”走向“靠证据”的最低门槛。 ## 一份 30 天的实操清单
第 1 周:审计当前导出工具的字段差异,建立字段映射表。 第 2 周:接入邮箱三层校验工具,建立校验时间戳字段。 第 3 周:建立 ICP 公司词典 + 角色族标签 + 行业标签三套主数据。 第 4 周:建立 4 级 Tier 评分卡 + BANT 预审字段。
30 天结束后,建立月度复盘节奏:命中率、Tier 分布、字段缺失原因、ICP 词典更新、责任人执行。每月复盘一次,季度大修一次。季度大修应至少包括 ICP 词典更新、字段规则修订、责任人轮换。
Tier 分布的健康基线
健康的 Tier 分布应该是:Hot 5%–10%、Warm 20%–30%、Nurture 30%–50%、Discard 10%–25%。如果 Hot 占比 > 15%,意味着 Tier 评级过宽,触达节奏会被低质量线索拖累;如果 Hot 占比 < 3%,意味着 Tier 评级过严,触达池过小。
健康的 Warm 占比应该是 20%–30%。如果 Warm 占比 > 40%,意味着 BANT 预审不充分;如果 Warm 占比 < 15%,意味着 BANT 预审过严,可能错失真实机会。
责任到人的 KPI
责任人的 KPI 应包括:人均 SQL 数、客户画像匹配度、线索转化为 SQL 的比率、复盘命中率。KPI 应每月公开排名,但不应被用作唯一激励;过度 KPI 化会扭曲责任人的判断。
责任人的轮换应每季度一次,避免长期绑定。轮换不是惩罚,是防止 IP 流失风险累积。 ## 邮件送达率与域名信誉度
邮件送达率是 SDR 触达的隐性 KPI。一次高无效率的触达会拖累发件域名的信誉度,进而拖累后续 30 天的送达率。Tier 分级 + 邮箱校验的输出是高送达率,而不是高发送量。
域名信誉度的恢复周期通常为 30–60 天,因此一次清洗失误的代价会被分摊到后续 30–60 天。建立月度清洗节奏比一次性大清洗更可持续。
与 CRM 字段对齐
Tier 标记应作为 CRM 标准字段,而不是自由文本字段。自由文本字段在统计时无法聚合,会让 Tier 分布失去意义。CRM 标准字段应至少包含:Tier 标记、校验时间戳、字段缺失原因、责任人对接 ID。
CRM 字段对齐的产出是 Tier 分布可统计、可复盘、可追责。没有字段对齐的 Tier 分级,本质上是电子版的名单即机会。
30 天试运行的成本结构
30 天试运行的成本结构包括:邮箱校验工具订阅费(年付 1–3 万元人民币)、ICP 词典建立人工成本(约 10–20 工时)、BANT 预审建立人工成本(约 5–10 工时)、责任人执行人力成本(按结果分成)。30 天试运行的总成本约为 5–15 万元人民币,远低于一份高质量名单的采购成本(约 30–50 万元人民币)。
低成本不等于低价值。30 天试运行的价值是建立可复制的清洗流程,而不是一次性的命中率提升。可复制的流程比一次性的命中率更有长期价值。
与采购自动化工具的协同
清洗流程的输出可以接入采购自动化工具(CPQ / Contract Lifecycle Management),把 Tier 标记转化为报价模板和合同条款。协同的产出是“清洗 + 报价”双向反馈:Tier 标记触发报价模板,报价模板回写 Tier 命中率。
协同的关键是报价模板的颗粒度。颗粒度太粗,无法匹配 Tier;颗粒度太细,难以维护。建立 8–12 个 Tier-报价模板组合是 2026 中国 SDR 团队的合理基线。
长期主义的清洗流程
清洗流程不是一次性项目,而是长期数据治理。每月一次小修,每季度一次大修,每年一次规则更新。规则更新应基于实际客户画像,而不是基于工具厂商的市场宣传。
建立 12–24 个月的清洗流程优化期,比追求 1–3 个月的命中率提升更符合 2026 中国 SDR 团队的现实。
一份可审计的清洗日志样本
清洗日志的字段应至少包括:导出批次 ID、导出工具、导出时间、原始字段数、清洗后字段数、邮箱校验通过率、公司名规范化命中率、角色族匹配率、行业匹配率、Tier 分布、责任人、清洗时间戳。可审计的日志让清洗流程可以被复盘、被复核、被追责。
没有可审计日志的清洗流程,本质上是数据团队的口头承诺,无法被销售团队信任。